스트림(Streams)을 이용하면 선언형으로 컬렉션(collection) 데이터를 처리할 수 있으며, (즉, 데이터를 처리하는 임시 구현 코드를 작성하는 대신 질의로 표현할 수 있게 됨)
멀티스레드 코드를 구현하지 않아도 데이터를 투명하게 병렬로 처리할 수 있다.
e.g., 저칼로리의 요리명을 반환하고, 칼로리를 기준으로 요리를 정렬하는 코드
-
자바 7 코드
// 저칼로리 요리들
List<Dish> lowCaloricDishes = new ArrayList<>(); // 가비지(garbage) 변수 : 컨테이너 역할만 하는 중간 변수
for(Dish dish : menu) { // 누적자로 요소 필터링
    if(dish.getCalories() < 400) {
        lowCaloricDishes.add(dish);
    }
}

// 익명 클래스로 요리들을 칼로리 기준으로 정렬
Collections.sort(lowCaloricDishes, new Comparator<Dish>() {
    public int compare(Dish dish1, Dish dish2) {
        return Integer.compare(dish1.getCalories(), dish2.getCalories());
    }
});

List<String> lowCaloricDishesName = new ArrayList();
for(Dish dish : lowCaloricDishes) {
    lowCaloricDishesName.add(dish.getName()); // 정렬된 리스트를 처리하면서 요리 이름 선택
}
-
스트림을 사용한 자바 8 코드
import static java.util.Comparator.comparing;
import static java.util.stream.Collectors.toList;
List<String> lowCaloricDishesName = menu.stream()
					.filter(d -> d.getCalories() < 400) // 400 칼로리 이하의 요리 선택
					.sorted(comparing(Dish::getCalories) // 칼로리로 요리 정렬
					.map(Dish::getName) // 요리명 추출
					.collect(toList()); // 모든 요리명을 리스트에 저장
위의 코드에서 stream()을
parallelStream()으로 바꾸면 이 코드를 멀티 코어 아키텍처에서 병렬로 실행할 수 있다.
선언형으로 코드를 구현할 수 있다.
선언형 코드와 동작 파라미터화를 통해서 변하는 요구사항에 쉽게 대응할 수 있다.
여러 빌딩 블록 연산(filter, sorted, map, collect 등)을 연결해서 복잡한 데이터 처리 파이프라인을 만들 수 있다. (
조립 가능)
여러 연산을 파이프라인으로 연결해도 여전히 가독성과 명확성이 유지된다.
데이터 처리 과정을
병렬화하면서 스레드와 락을 걱정할 필요가 없으며, 성능이 좋아진다.
filter, sorted, map, collect 같은 연산은 고수준 빌딩 블록(high-level building block)으로 이루어져 있다.
이들은 특정 스레딩 모델에 제한되지 않고 어떤 상황에서든 자유롭게 사용할 수 있다.
💡 데이터 처리 연산을 지원하도록 소스에서 추출된 연속된 요소 (Sequence of elements)
스트림은 컬렉션과 마찬가지로 특정 요소 형식으로 이루어진 연속된 값 집합의 인터페이스를 제공한다.
하지만 컬렉션의 주제는 데이터고, 스트림의 주제는 계산이다. (4.3절에서 자세히 다룸)
스트림은 데이터 제공 소스(e.g., 컬렉션, 배열, I/O 자원 등)로부터 데이터를 소비한다.
정렬된 컬렉션으로 스트림을 생성하면 정렬이 그대로 유지된다.
filter, map, reduce, find, match, sort 등으로 데이터를 조작할 수 있으며,
스트림 연산은 순차적으로 또는 병렬로 실행할 수 있다.
대부분의 스트림 연산은 스트림 자신을 반환한다.
따라서 스트림 연산끼리 연결해서 파이프라인을 구성할 수 있으며,
덕분에 게으름(laziness), 쇼트서킷(short-circuiting) 같은 최적화도 얻을 수 있다. (5장에서 설명함)
반복자를 이용해서 명시적으로 반복하는 컬렉션과 달리, 스트림은 내부 반복을 지원한다. (4.3.2절에서 설명함)
스트림 라이브러리에서 필터링(fliter), 추출(map), 축소(limit) 기능을 제공하므로 직접 기능을 구현할 필요가 없으며,
결과적으로 스트림 API는 파이프라인을 더 최적화할 수 있는 유연성을 제공한다.
자바의 기존 컬렉션과 새로운 스트림 모두 연속된(sequenced, 순차적인) 요소 형식의 값을 저장하는 자료구조의 인터페이스를 제공한다.
💡 데이터를 언제 계산하느냐가 둘의 가장 큰 차이다.
-
컬렉션: 현재 자료구조가 포함하는 모든 값을 메모리에 저장하는 자료구조- 컬렉션의 모든 요소는 컬렉션에 추가하기 전에 계산되어야 한다.
-
스트림: 요청할 때만 요소를 계산하는 고정된 자료구조 (= 게으르게 만들어지는 컬렉션)- 사용자가 요청하는 값만 스트림에서 추출한다.
- 생산자(producer)와 소비자(consumer) 관계를 형성한다.
스트림은 반복자와 마찬가지로 한 번만 탐색할 수 있다.
즉, 탐색된 스트림의 요소는 소비된다.
한 번 탐색한 요소를 다시 탐색하려면 초기 데이터 소스에서 새로운 스트림을 만들어야 하는데,
이를 위해서는 컬렉션처럼 반복 사용할 수 있는 데이터 소스여야 한다.
아래 예시처럼 데이터 소스가 I/O 채널일 경우, 소스를 반복 사용할 수 없으므로 새로운 스트림을 만들 수 없다.
List<String> title = Arrays.asList("Java8","In","Action");
Stream<String> s = title.stream();
s.forEach(System.out::println); // title의 각 단어를 출력
s.forEach(System.out::println); // IllegalStateException: 스트림이 이미 소비되었거나 닫힘컬렉션과 스트림의 또 다른 차이점은 데이터 반복 처리 방법이다.
-
for-each 등을 사용해서 사용자가 직접 요소를 반복해야 한다.
-
e.g.,
List<String> names = new ArrayList<>();
for(Dish dish : menu) { // 메뉴 리스트를 명시적으로 순차 반복함
    names.add(dish.getName());
}
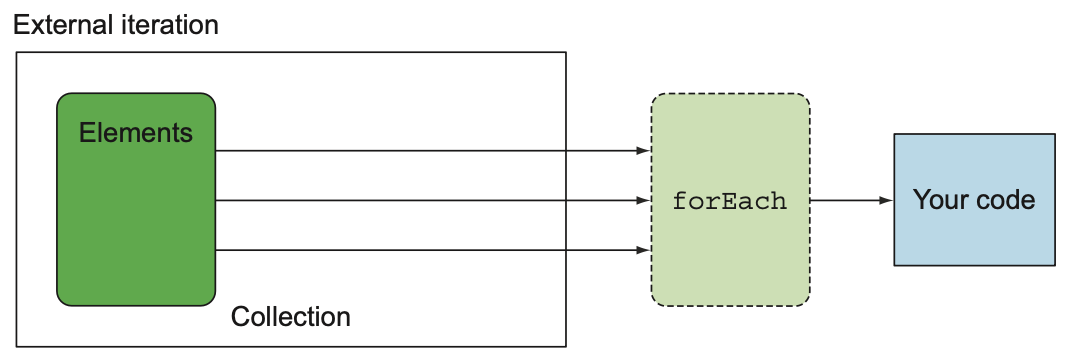
-
반복을 알아서 처리하고 결과 스트림값을 어딘가에 저장해준다.
-
e.g.,
List<String> names = menu.stream()
		         .map(Dish::getName) // 요리명을 추출 (map 메서드를 getName 메서드로 파라미터화)
			 .collect(toList()); // 파이프라인을 실행, 반복자는 필요 없음
-
작업을 투명하게 병렬로 처리하거나 더 최적화된 다양한 순서로 처리할 수 있게 된다.
-
스트림 라이브러리의 내부 반복은 데이터 표현과 하드웨어를 활용한 병렬성 구현을 자동으로 선택한다.
- 외부 반복에서는 병렬성을 스스로 관리해야 한다.
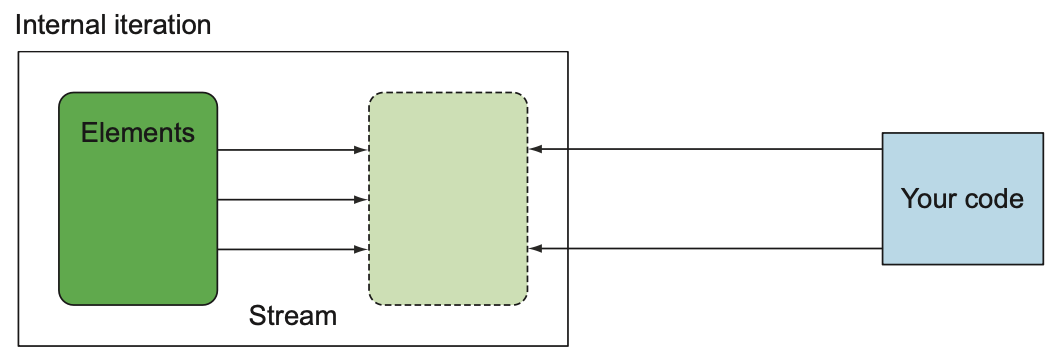
스트림 인터페이스의 연산은 크게 두 가지로 구분할 수 있다.
중간 연산(intermediate operation): 연결할 수 있는 스트림 연산 (파이프라인을 형성)최종 연산(terminal operation): 스트림을 닫는 연산
e.g.,
List<String> names = menu.stream()
                         .filter(dish->dish.getCalories()>300) // 중간 연산
                         .map(Dish::getName) // 중간 연산
                         .limit(3) // 중간 연산
                         .collect(toList()); // 최종 연산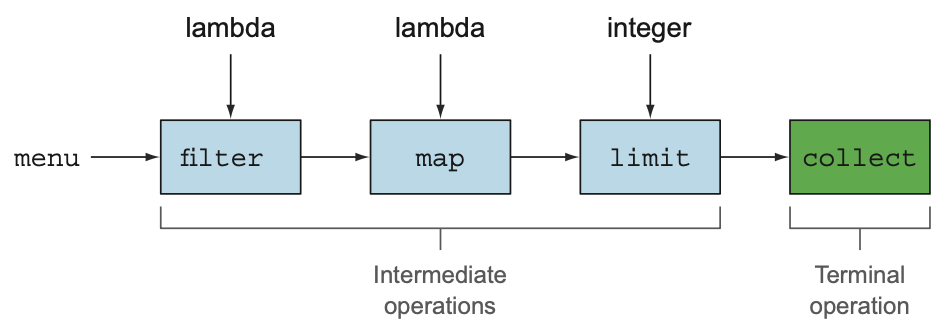
여러 중간 연산을 연결해서 질의를 만들 수 있다.
중간 연산은 게으르다(lazy).
단말 연산을 스트림 파이프라인에 실행하기 전까지는 아무 연산도 수행하지 않는다.
💡 중간 연산을 합친 다음에 합쳐진 중간 연산을 최종 연산으로 한 번에 처리하기 때문이다.
e.g.,
List<String> names = menu.stream()
                         .filter(dish->{
                             System.out.println("filtering:"+dish.getName());
                             return dish.getCalories()>300;
                         }) // 필터링한 요리명 출력
                         .map(dish->{
                             System.out.println("mapping:"+dish.getName());
                             return dish.getName();
                         }) // 추출한 요리명 출력
                         .limit(3)
                         .collect(toList());
System.out.println(names);
프로그램 실행 결과는 다음과 같다.
filtering:pork
mapping:pork
filtering:beef
mapping:beef
filtering:chicken
mapping:chicken
[pork, beef, chicken]
-
limit 연산과쇼트서킷 기법(5장에서 설명함) 덕분에 300 칼로리가 넘는 요리는 여러 개지만 오직 처음 3개만 선택되었다. -
루프 퓨전(loop fusion): filter와 map은 서로 다른 연산이지만 한 과정으로 병합되었다.
스트림 이용 과정은 세 가지로 요약할 수 있다.
- 질의를 수행할
데이터 소스(e.g., 컬렉션) - 스트림 파이프라인을 구성할
중간 연산연결 - 스트림 파이프라인을 실행하고 결과를 만들
최종 연산